
Como criar um agente de voz com IA usando a Cartesia
Cansado das conversas robóticas com Siri e Alexa que terminam em “Desculpe, não entendi”? O futuro da IA de voz chegou. Os novos agentes conseguem conversar naturalmente, entender o contexto e responder com uma inteligência semelhante à humana.
Ao contrário dos assistentes tradicionais, que apenas executam comandos básicos, esses agentes transformam a experiência do cliente. Em vez de navegar por menus cansativos de “Pressione 1 para inglês”, você pode simplesmente dizer do que precisa, como faria com uma pessoa.
Vamos explorar como criar esses agentes usando a API da Cartesia.
O que são agentes de voz com IA?
Agentes de voz com IA são sistemas inteligentes que conversam naturalmente com humanos. Eles entendem e respondem à linguagem falada, de perguntas simples a tarefas complexas. Combinam reconhecimento de fala, processamento de linguagem natural e tecnologia de texto para fala para criar interações de voz fluidas.
Eles podem realizar muitas tarefas rotineiras, como:
- Responder a perguntas frequentes
- Agendar compromissos
- Consultar o status de um pedido
- Encaminhar chamadas ao departamento correto
- Oferecer suporte básico para resolver problemas
Ao delegar essas interações à IA, as equipes podem se concentrar em trabalhos mais complexos e relevantes, usando melhor seu tempo e seus recursos.
Como funcionam os agentes de voz com IA?
Esses agentes processam a fala humana, interpretam a intenção, recuperam informações das bases de conhecimento da empresa, produzem respostas adequadas em texto e as entregam em uma voz natural e conversacional.
O fluxo funciona assim:
- Fala para texto, ou ASR. O usuário fala, e o sistema transcreve sua voz usando reconhecimento de fala.
- Processamento de linguagem natural. O sistema analisa o texto para entender o significado e a intenção, incluindo contexto e nuances.
- Recuperação de informações. Com base na intenção identificada, o agente busca informações relevantes na base de conhecimento para elaborar a resposta.
- Geração da resposta. A IA produz uma resposta adequada ao contexto da conversa e às informações recuperadas.
- Texto para fala. O agente converte a resposta em fala natural para o usuário, criando uma experiência conversacional.
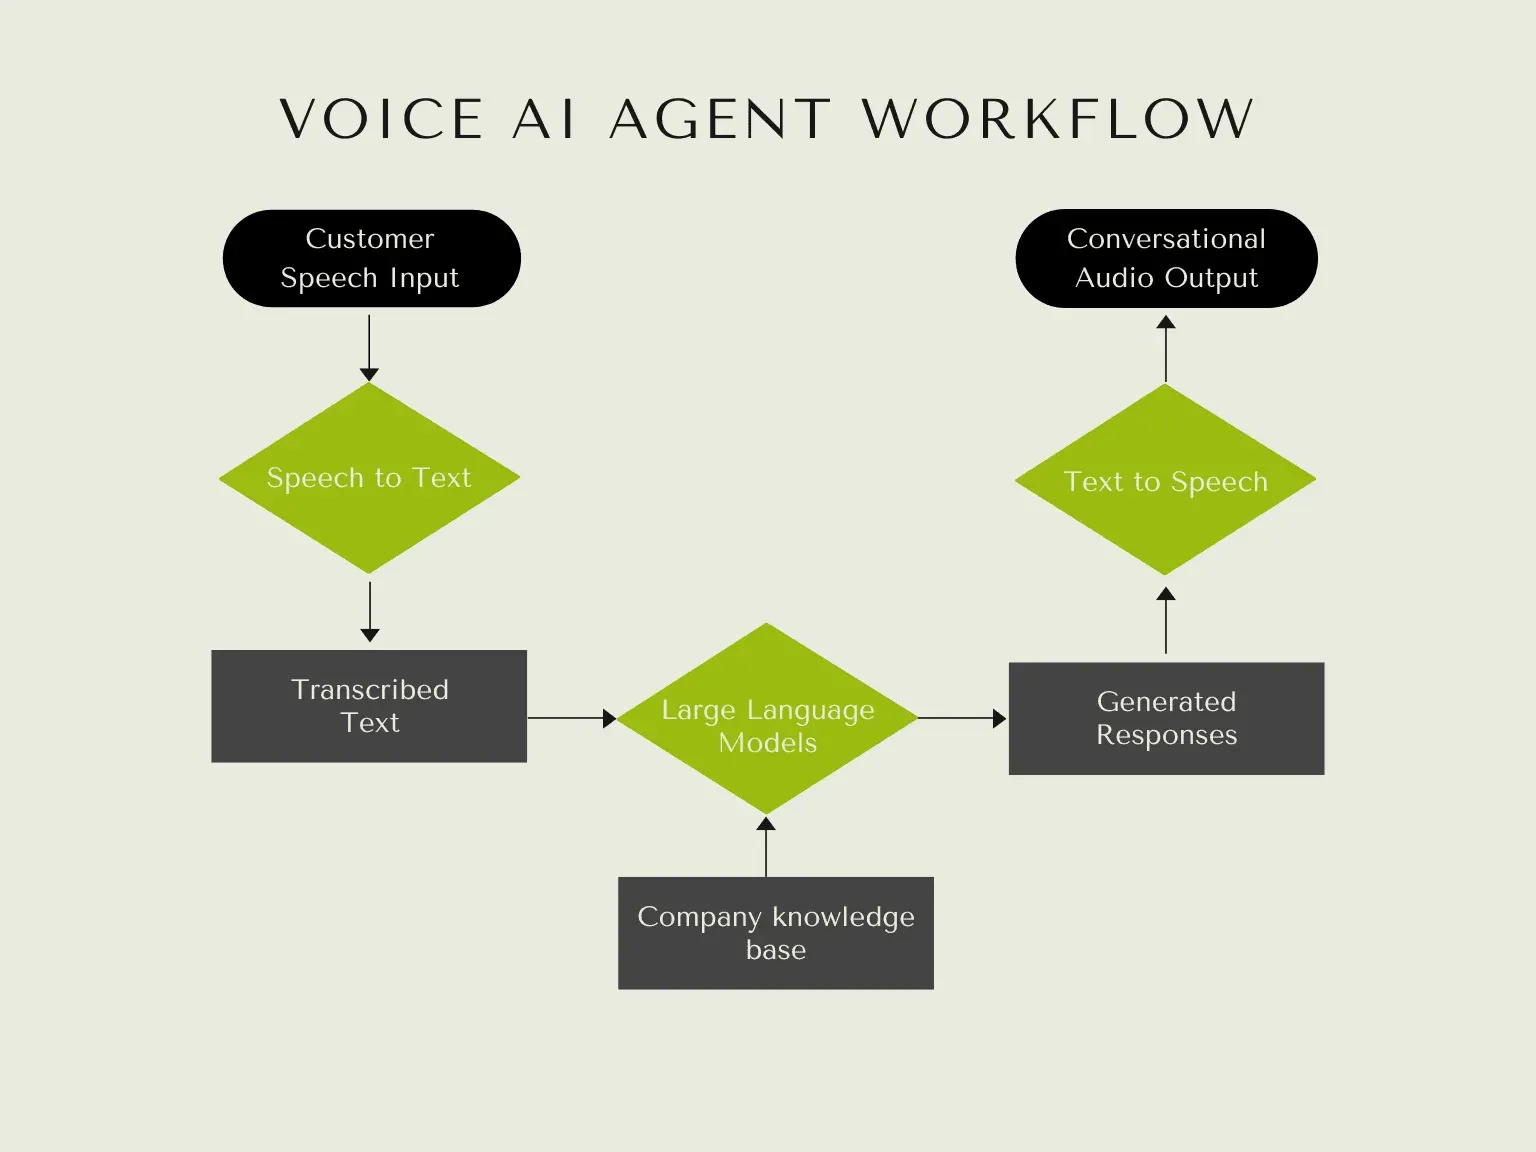
Fluxo de um agente de voz com IA
O agente pode começar seguindo um roteiro pré-gravado, como “Meu nome é _____. Como posso ajudar hoje?”.
Seu sistema pode gravar as respostas do usuário, converter a fala em texto e enviar esse texto ao LLM ou sistema interno de IA em tempo real. O LLM gera uma resposta em texto, que volta ao agente para ser convertida em fala. A conversa pode fluir entre o agente e o usuário até que o sistema alcance seu objetivo, como confirmar um compromisso ou resolver um problema comum.
Crie um agente de voz com a API da Cartesia em Python
Este tutorial mostra como configurar um agente de voz usando a API da Cartesia e o modelo Sonic.
Configure o ambiente
Para usar a API da Cartesia, você precisa de uma conta, uma chave de API e FFmpeg instalado. Siga estes passos:
- Crie uma conta no Cartesia Play.
- Obtenha sua chave em Cartesia API Keys.
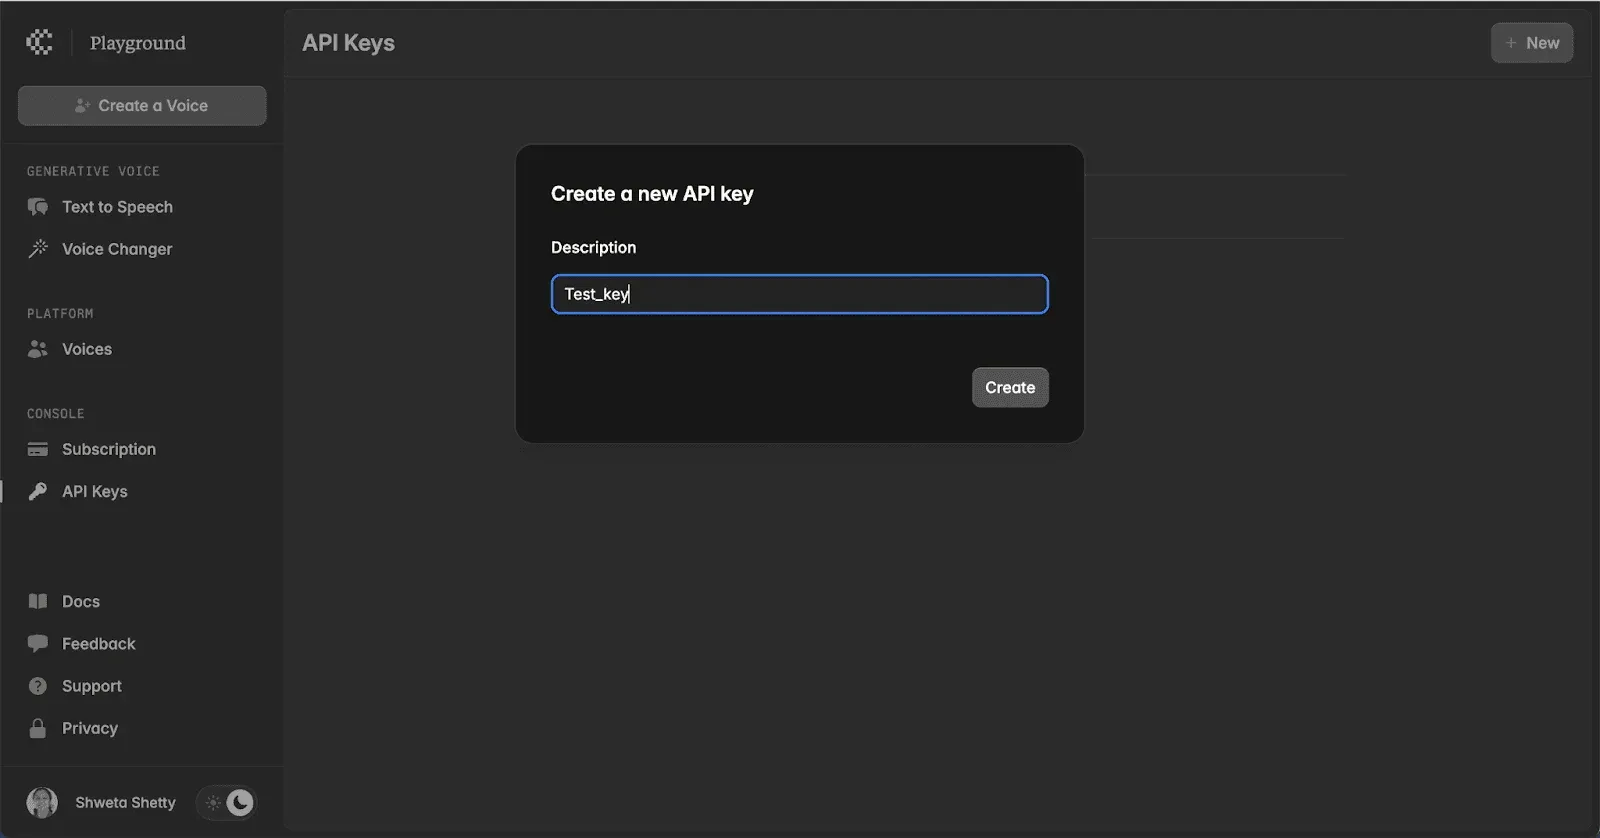
- Instale o FFmpeg para processar áudio, como mostrado abaixo.
# On Ubuntu/Debian
  sudo apt update && sudo apt install ffmpeg

# On macOS (using Homebrew)
  brew install ffmpeg

# On Windows (using Chocolatey)
  choco install ffmpeg
O FFmpeg não é obrigatório para usar a API da Cartesia, mas ajuda a converter, salvar e reproduzir arquivos de áudio.
Escolha seu endpoint de fala para texto
Primeiro, você precisa gravar a entrada do cliente e convertê-la em texto. Há várias opções de tecnologia para isso. Por exemplo, a API Whisper, desenvolvida pela OpenAI, aceita vários formatos de áudio e transcreve fala em diferentes idiomas. Também pode traduzir fala de outros idiomas para inglês. Como alternativa, você pode usar Google Speech to Text, Amazon Transcribe, Azure AI Speech, Assembly, Deepgram ou Speechmatics.
Gere uma resposta a partir do texto transcrito
A geração da resposta depende da função principal da sua aplicação. Se o agente atua na saúde, por exemplo, precisa se comunicar com seus aplicativos médicos de IA e suas bases de dados existentes. Para agendar compromissos, deve consultar dados de aplicativos de calendário. Normalmente, essa função exige outro modelo de IA com mais capacidade de raciocínio, como Anthropic Claude Sonnet ou os modelos OpenAI O1 ou 4O.
Ou use uma plataforma de agentes de voz
Se tudo isso parecer complicado demais para configurar, experimente plataformas como LiveKit, VAPI ou RASA para começar.
Uma prova de conceito simples exige apenas cinquenta linhas de código, sem contar linhas em branco e comentários:
load_dotenv(dotenv_path=".env.local")
logger = logging.getLogger("voice-agent")

def prewarm(proc: JobProcess):
  proc.userdata["vad"] = silero.VAD.load()
async def entrypoint(ctx: JobContext):
  initial_chat_context = llm.ChatContext().append(
      role="system",
      text=(
        "You are a voice assistant created by LiveKit. Your interface with users will be voice. "
        "You should use short and concise responses, and avoid usage of unpronounceable punctuation. "
      ),
  )
  logger.info(f"connecting to room {ctx.room.name}")
  await ctx.connect(auto_subscribe=AutoSubscribe.AUDIO_ONLY)
  # Wait for the first participant to connect
  participant = await ctx.wait_for_participant()
  logger.info(f"starting voice assistant for participant {participant.identity}")

  # Set up the Agent
    agent = VoicePipelineAgent(
      vad=ctx.proc.userdata["vad"],
      stt=deepgram.STT(),
      llm=openai.LLM(model="gpt-4o-mini"),
      tts=cartesia.TTS(
        model="sonic-3.5",
        voice="a0e99841-438c-4a64-b679-ae501e7d6091",
      ),
      chat_ctx=initial_chat_context,
    )
     agent.start(ctx.room, participant)

  # Once connected, we start by hardcoding a greeting
    await agent.say(f"Hey {participant.identity}! How can I help you today?", allow_interruptions=True)

  if __name__ == "__main__":
    cli.run_app(
      WorkerOptions(
        entrypoint_fnc=entrypoint,
        prewarm_fnc=prewarm,
      ),
    )
Formate o texto de entrada
Formatar bem o texto é essencial para produzir fala natural. Algumas práticas recomendadas:
- Use pontuação para indicar perguntas e ênfase, deixando a fala natural.
- Escreva abreviações por extenso para evitar erros de pronúncia, como “Doctor” em vez de “Dr.”.
- Organize o texto de acordo com a cadência natural da fala.
Você também pode usar tags
Exemplo de roteiro
Olá! Obrigado por ligar para nosso atendimento ao cliente.
<break time="1s" />
  I’m Anna, how can I help you today?
<break time="1s" />
  Could you please provide your order number so we can get started? We’ll resolve this as quickly as possible and keep you updated.
<break time="1s" />
Escolha seu endpoint de texto para fala
A Cartesia oferece vários endpoints TTS. Os endpoints WebSocket e de streaming são adequados a agentes interativos pelos seguintes motivos:
- Latência: você pode estabelecer a conexão WebSocket antecipadamente, evitando a latência de conexão quando começa a gerar fala. Isso normalmente economiza cerca de 200ms.
- Entrada em streaming: você pode enviar entradas aos poucos e preservar a prosódia da fala gerada, algo útil ao gerar texto em tempo real com um LLM.
- Marcas de tempo: você pode obter transcrições com marcas de tempo para criar legendas ou transcrições ao vivo. Há limites de modelo e idioma. Consulte a comparação de endpoints TTS.
- Multiplexação: você pode executar várias conversas por uma única conexão.
O endpoint TTS bytes, via POST, é ideal para gerar antecipadamente um arquivo de áudio. Ele permite produzir vários formatos, como WAV e MP3.
Antes de escolher, consulte a documentação de endpoints TTS da Cartesia para identificar o mais adequado à sua aplicação.
Chame a API
Depois de formatar o texto, envie-o ao endpoint TTS escolhido. A API espera um payload JSON com o texto e parâmetros opcionais de configuração. Veja como configurar isso com o SDK da Cartesia para Python.
pip install cartesia

# Or using uv
uv add cartesia

# Make the API call
import os
import subprocess
from cartesia import Cartesia
if os.environ.get("CARTESIA_API_KEY") is None:
  raise ValueError("CARTESIA_API_KEY is not set")

client = Cartesia(api_key=os.environ.get("CARTESIA_API_KEY"))

response = client.tts.generate(
  model_id="sonic-3.5",
  transcript="Hello, world! I'm generating audio on Cartesia.",
  voice={"mode": "id", "id": "a0e99841-438c-4a64-b679-ae501e7d6091"},  # Greg - Supporter
  language="en",

  # You can find the supported output_format at https://docs.cartesia.ai/api-reference/tts/bytes
  output_format={
    "container": "wav",
    "encoding": "pcm_f32le",
    "sample_rate": 44100,
  },
)
with open("sonic.wav", "wb") as f:
  f.write(response.read())
# Play the file
subprocess.run(["ffplay", "-autoexit", "-nodisp", "sonic.wav"])
Execute o script assim:
env CARTESIA_API_KEY=YOUR_API_KEY python cartesia.py

# On uv
env CARTESIA_API_KEY=YOUR_API_KEY uv run cartesia.py
O script envia o texto ao modelo Sonic, recebe o áudio e o salva como um arquivo .wav.
Configure seu agente de voz
A API da Cartesia permite personalizar a saída de voz, incluindo velocidade, emoção e localização.
Velocidade
Para personalizar a velocidade, adicione o parâmetro speed ao dicionário __experimental_controls do objeto voice na solicitação da API.
As opções são:
- “slowest”: fala muito lenta
- “slow”: fala mais lenta que o normal
- “normal”: velocidade padrão
- “fast”: fala mais rápida que o normal
- “fastest”: fala muito rápida
Você também pode definir a velocidade com um número no intervalo [−1.0,1.0] para ter mais controle. O valor 0 representa a velocidade padrão. Valores negativos desaceleram a fala e positivos a aceleram.
"voice": {
  "mode": "id",
  "id": "VOICE_ID",
  "__experimental_controls": {
    "speed": "fast,
  }
}
Emoção
Para personalizar a emoção, adicione o parâmetro emotion ao dicionário __experimental_controls do objeto voice na solicitação da API. Ele é uma lista de tags no formato emotion_name: level.
Os nomes de emoção podem ser anger, positivity, surprise, sadness e curiosity.
Os níveis são lowest, low, high e highest. Eles são apenas aditivos. Por exemplo, “surprise: low” adiciona um pouco de surpresa à voz, em vez de deixá-la menos surpresa. Omita o nível para adicionar uma intensidade moderada da emoção.
"voice": {
  "mode": "id",
  "id": "VOICE_ID",
  "__experimental_controls": {
    "emotion": [
    "positivity:high",
    ]
  }
}
Envie entradas em streaming
Em aplicações interativas, você pode querer gerar fala dinamicamente a partir de um modelo de IA, como um LLM. A API da Cartesia oferece geração de voz em tempo real por meio de um recurso chamado continuações. Elas retomam a geração de onde a anterior parou, preservando o padrão sonoro e o contexto.
Configure a continuação com context_id no texto de entrada. Todas as palavras e frases de uma sentença contínua devem usar o mesmo context_id.
{"transcript":
   "Hello, Sonic!",
   "continue": true,
   "context_id": "stream1"
}
{"transcript":
   " I'm streaming ",
   "continue": true,
   "context_id": "stream1"
}
{"transcript":
   "inputs.",
   "continue": false,
   "context_id": "stream1"
}
Envie a solicitação de geração com context_id ao endpoint TTS WebSocket. Entradas posteriores com o mesmo context_id continuam a geração, preservando a prosódia.
Esse recurso é útil para agentes de voz, chatbots e experiências interativas.
Perguntas frequentes sobre agentes de voz com IA
A tecnologia de IA de voz já pode ser usada?
Sim. Empresas já adotam soluções de IA de voz. Plataformas como a Cartesia permitem gerar voz de alta qualidade, com baixa latência e naturalidade conversacional. Os agentes podem responder a perguntas com base em uma base de informações e realizar tarefas como agendar compromissos, criar registros no CRM, fazer chamadas de saída e qualificar leads.
Que tipos de empresa podem se beneficiar de agentes de voz com IA?
Setores como saúde, centrais de atendimento, jogos e seguros de saúde já usam esses agentes. Qualquer empresa com alto volume mensal de chamadas pode se beneficiar, automatizando interações com clientes e melhorando a eficiência operacional.
Os agentes podem falar outros idiomas além do inglês?
Sim. Agentes de voz podem oferecer vários idiomas, mas a qualidade depende do fornecedor de texto para fala. A Cartesia, por exemplo, oferece suporte a 15 idiomas, incluindo espanhol, alemão, francês, italiano e hindi.
Quanto os agentes de voz podem ser personalizados?
Eles podem ser adaptados às necessidades específicas da sua empresa. Podem ser treinados com os dados da empresa para responder corretamente às perguntas dos clientes, e suas vozes podem seguir suas preferências. Também podem se integrar aos sistemas existentes, como sites, plataformas de CRM, calendários e qualquer software com endpoints de API, facilitando a integração aos fluxos atuais.
Os agentes de voz ainda soam robóticos?
Não. A tecnologia moderna reduziu muito a fala com som robótico. A geração lida melhor com pausas naturais, interrupções e nuances da conversa. Está cada vez mais difícil distinguir fala gerada por IA de fala humana, especialmente com fornecedores TTS de alta qualidade, como a Cartesia.