
Cartesiaで音声AIエージェントをつくる
SiriやAlexaとの機械的な会話が「すみません、わかりません」で終わることに疲れていませんか。新しい音声AIエージェントは自然に会話し、文脈を理解し、人間らしい知性で応答します。
基本的な命令を実行する従来の音声アシスタントと異なり、これらのエージェントは顧客体験を変えます。「英語は1を押してください」という面倒な電話メニューを進む代わりに、人に話すように必要なことを伝えられます。
Cartesia APIを使って、このような音声AIエージェントをつくる方法を見ていきましょう。
音声AIエージェントとは
音声AIエージェントは、人と自然に会話する知的なシステムです。単純な質問への回答から複雑な作業まで、話された言葉を理解して応答できます。音声認識、自然言語処理、音声合成を組み合わせて、滑らかな音声のやり取りを実現します。
次のような日常的な作業を扱えます。
- よくある質問への回答
- 予約の設定
- 注文状況の確認
- 適切な部署への電話の振り分け
- 基本的な問題解決の支援
こうした対応をAIに任せると、チームはより複雑で重要な仕事に集中でき、時間や資源を有効に使えます。
音声AIエージェントの仕組み
AIで人の発話を処理し、意図を理解し、企業の知識ベースから情報を取得して、適切なテキストの応答を組み立て、自然な会話の声で届けます。
処理の流れは次のとおりです。
- 音声認識(ASR)。ユーザーの声をテキストに変換します。
- 自然言語処理。文脈や細かな意味を含め、テキストから意味と意図を理解します。
- 情報検索。理解した意図に基づき、知識ベースから応答に必要な情報を取得します。
- 応答生成。会話の文脈と取得した情報をもとに、適切な応答を生成します。
- 音声合成。応答のテキストを自然な音声に変換し、会話として届けます。
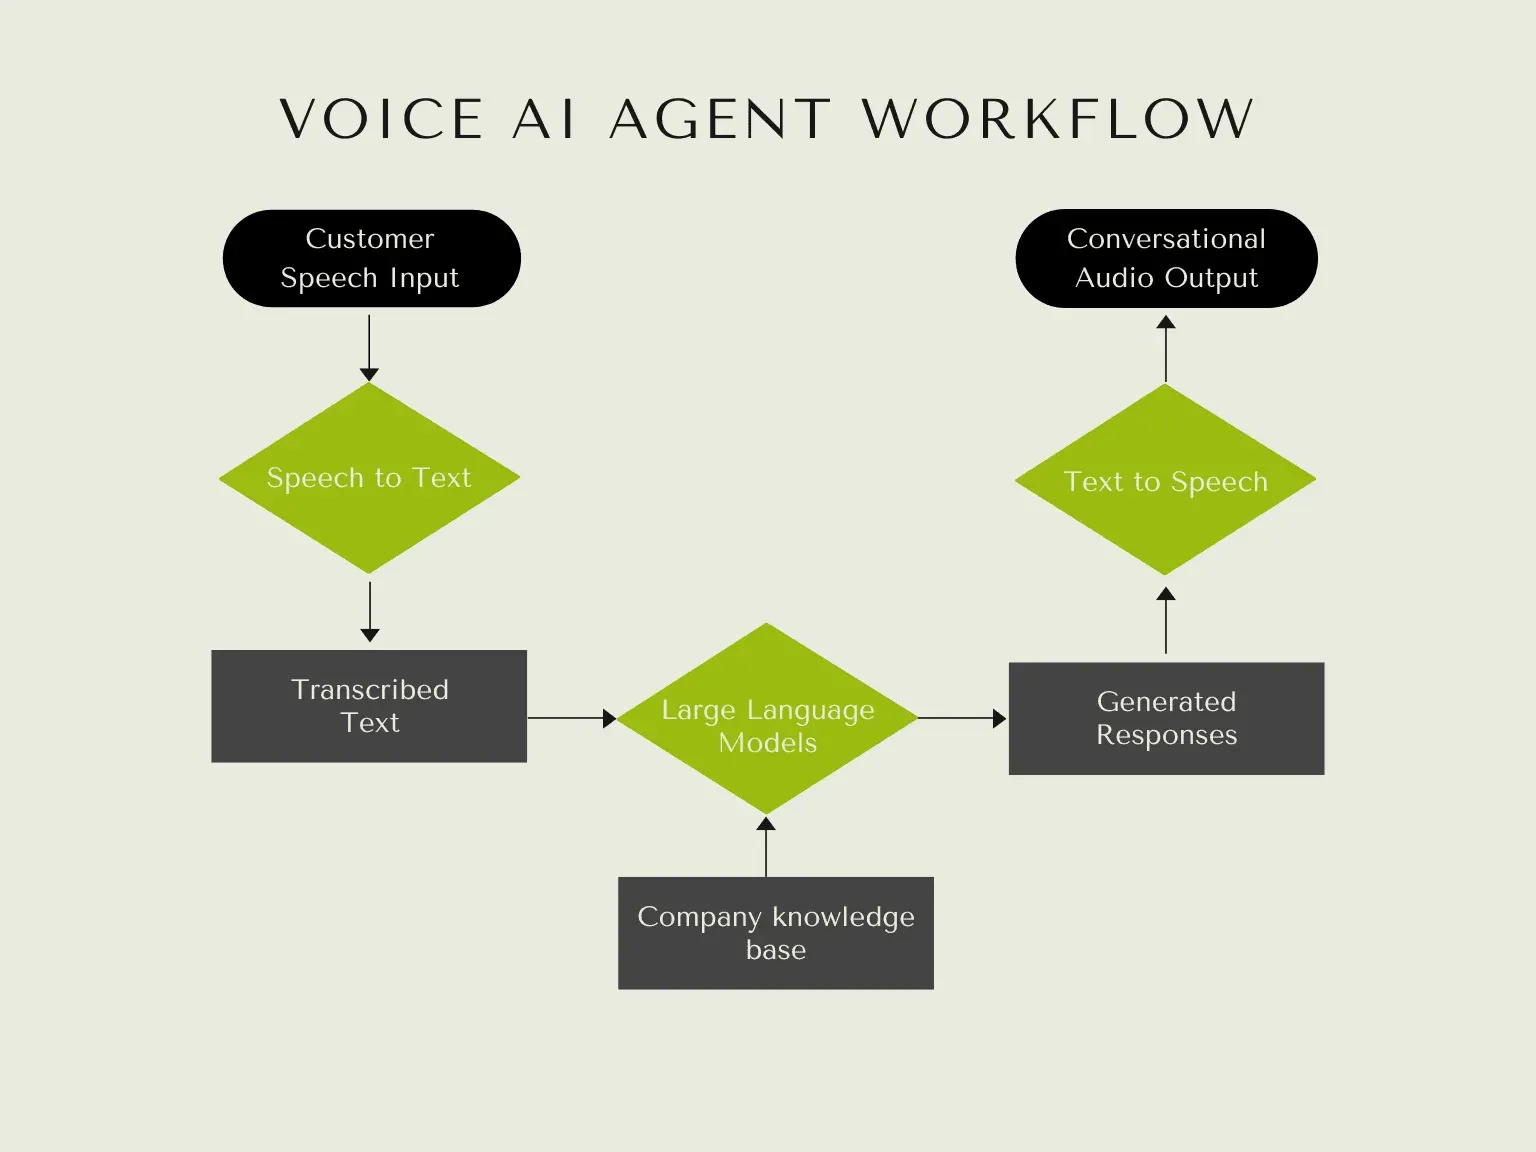
音声AIエージェントの処理の流れ
エージェントは、事前に録音した台本に沿って会話を始められます。たとえば「私は〇〇です。本日はどのようなご用件でしょうか」と話します。
システムはユーザーの応答を録音し、文字に変換して、リアルタイムでLLMや社内のAIシステムに渡します。LLMが適切なテキストを生成し、それを音声AIエージェントに戻して音声に変換します。予約の確定やよくある問題の解決など、目的を達成するまで流暢に会話を続けられます。
PythonとCartesia APIで音声AIエージェントを開発する
このチュートリアルでは、Cartesia APIとSonicモデルを使って音声AIエージェントを設定します。
環境を準備する
Cartesia APIを使うには、アカウント、APIキー、インストール済みのFFmpegを用意します。
- Cartesia Playでアカウントを作成します。
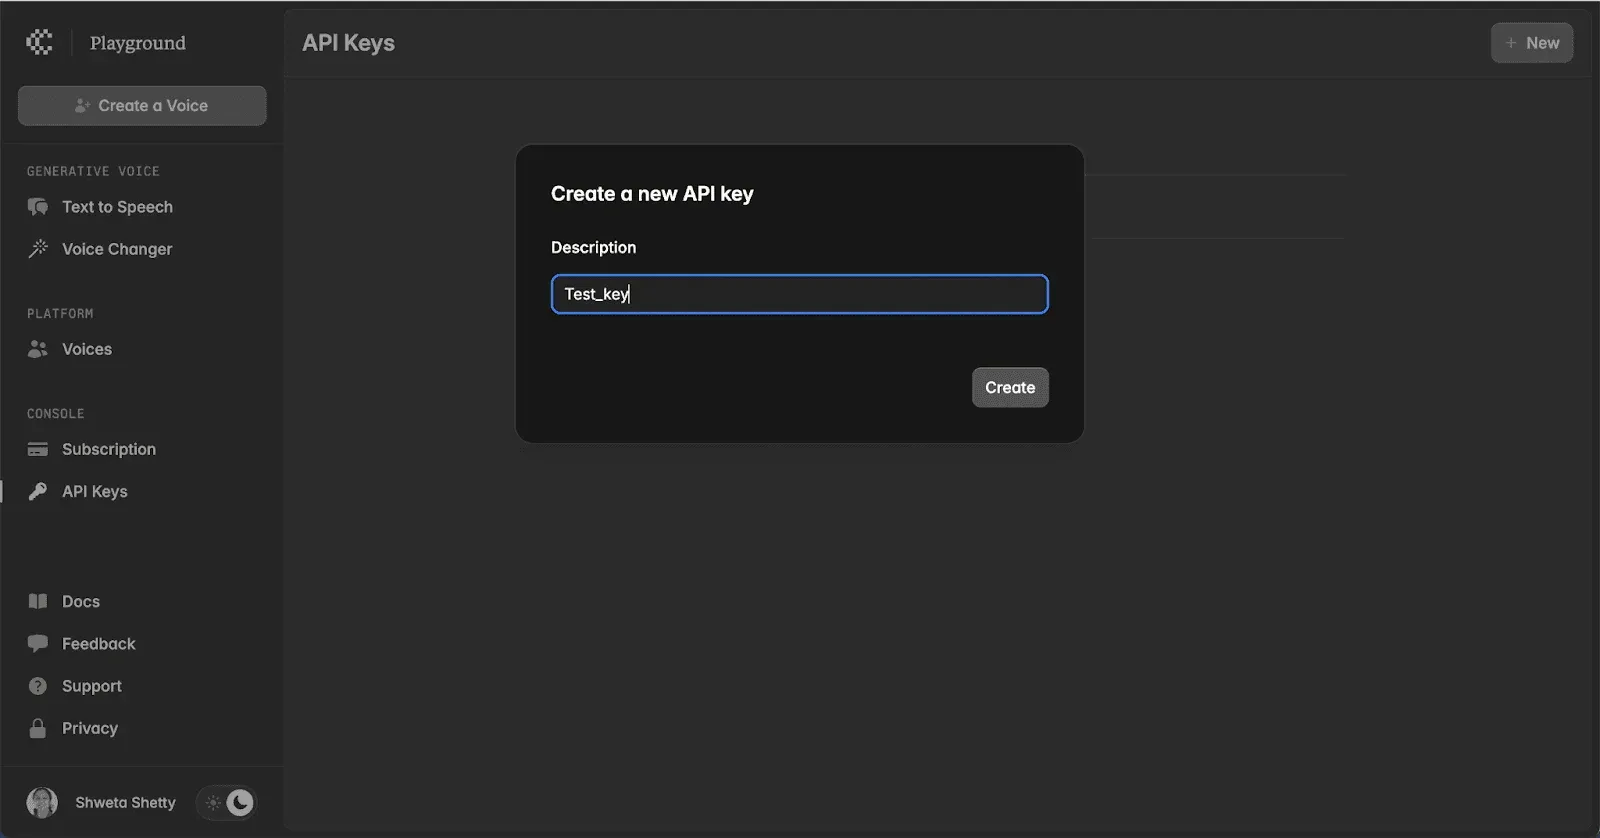
- Cartesia API KeysでAPIキーを取得します。
- 次のように、音声処理用のFFmpegをインストールします。
# On Ubuntu/Debian
  sudo apt update && sudo apt install ffmpeg

# On macOS (using Homebrew)
  brew install ffmpeg

# On Windows (using Chocolatey)
  choco install ffmpeg
FFmpegはCartesia APIの利用に必須ではありませんが、音声ファイルの変換、保存、再生に役立ちます。
音声認識のエンドポイントを選ぶ
最初に、顧客の音声を録音してテキストに変換します。音声認識には複数の選択肢があります。OpenAIのWhisper APIは、さまざまな音声形式と多言語の文字起こしに対応し、英語以外の音声を英語へ翻訳することもできます。
他にもGoogle Speech to Text、Amazon Transcribe、Azure AI Speech、Assembly、Deepgram、Speechmaticsがあります。
文字起こししたテキストから応答を生成する
応答の生成方法は、AIアプリの中核となる機能によります。医療のエージェントなら、既存の医療AIアプリや医療データベースと連携する必要があります。予約ならカレンダーのデータを調べます。通常は、Anthropic Claude SonnetやOpenAI O1、4Oなど、推論能力の高い別のAIモデルを使って実装します。
音声AIエージェントのプラットフォームを利用する
設定が複雑に感じられるなら、LiveKit、VAPI、RASAなどの基盤を使って開発を始めることもできます。
最も単純な試作品なら、空行とコメントを除いてわずか50行のコードです。
load_dotenv(dotenv_path=".env.local")
logger = logging.getLogger("voice-agent")

def prewarm(proc: JobProcess):
  proc.userdata["vad"] = silero.VAD.load()
async def entrypoint(ctx: JobContext):
  initial_chat_context = llm.ChatContext().append(
      role="system",
      text=(
        "You are a voice assistant created by LiveKit. Your interface with users will be voice. "
        "You should use short and concise responses, and avoid usage of unpronounceable punctuation. "
      ),
  )
  logger.info(f"connecting to room {ctx.room.name}")
  await ctx.connect(auto_subscribe=AutoSubscribe.AUDIO_ONLY)
  # Wait for the first participant to connect
  participant = await ctx.wait_for_participant()
  logger.info(f"starting voice assistant for participant {participant.identity}")

  # Set up the Agent
    agent = VoicePipelineAgent(
      vad=ctx.proc.userdata["vad"],
      stt=deepgram.STT(),
      llm=openai.LLM(model="gpt-4o-mini"),
      tts=cartesia.TTS(
        model="sonic-3.5",
        voice="a0e99841-438c-4a64-b679-ae501e7d6091",
      ),
      chat_ctx=initial_chat_context,
    )
     agent.start(ctx.room, participant)

  # Once connected, we start by hardcoding a greeting
    await agent.say(f"Hey {participant.identity}! How can I help you today?", allow_interruptions=True)

  if __name__ == "__main__":
    cli.run_app(
      WorkerOptions(
        entrypoint_fnc=entrypoint,
        prewarm_fnc=prewarm,
      ),
    )
入力テキストを整える
自然に聞こえる音声には、適切な形式のテキストが欠かせません。
- 句読点で疑問や強調を示し、自然に聞こえるようにする。
- 「Dr.」を「Doctor」と書くなど、略語を展開して読み間違いを防ぐ。
- 自然な話し方のリズムに合うよう文章を組み立てる。
台本の例
「こんにちは。カスタマーサービスにお電話いただき、ありがとうございます。」以下は英語の台本例です。
<break time="1s" />
  I’m Anna, how can I help you today?
<break time="1s" />
  Could you please provide your order number so we can get started? We’ll resolve this as quickly as possible and keep you updated.
<break time="1s" />
音声合成のエンドポイントを選ぶ
Cartesiaには複数のTTSエンドポイントがあります。対話型の音声エージェントには、次の理由からWebSocketとストリーミングのエンドポイントが適しています。
- レイテンシ。先にWebSocket接続を確立すれば、生成を始めるときに接続の遅れが発生しません。通常は約200ミリ秒を節約できます。
- 入力のストリーミング。生成音声の韻律を保ちながら入力を逐次送信できます。LLMなどでテキストをリアルタイムに生成するときに有効です。
- タイムスタンプ。生成音声の時刻付きテキストを取得し、字幕やライブ文字起こしをつくれます。モデルと言語による制限はTTSエンドポイントの比較をご覧ください。
- 多重化。一つの接続で複数の会話を扱えます。
TTS bytesのPOSTエンドポイントは、音声ファイルを事前に生成する用途に適しています。WAVやMP3などの形式で出力できます。
選ぶ前にCartesia TTS EndpointsのAPIドキュメントを確認し、アプリケーションに合うものを判断してください。
APIを呼び出す
整えたテキストを、選んだTTSエンドポイントに送ります。APIは、テキストと任意の設定パラメーターを含むJSONを受け取ります。Python向けCartesia SDKでは、次のように設定できます。
pip install cartesia

# Or using uv
uv add cartesia

# Make the API call
import os
import subprocess
from cartesia import Cartesia
if os.environ.get("CARTESIA_API_KEY") is None:
  raise ValueError("CARTESIA_API_KEY is not set")

client = Cartesia(api_key=os.environ.get("CARTESIA_API_KEY"))

response = client.tts.generate(
  model_id="sonic-3.5",
  transcript="Hello, world! I'm generating audio on Cartesia.",
  voice={"mode": "id", "id": "a0e99841-438c-4a64-b679-ae501e7d6091"},  # Greg - Supporter
  language="en",

  # You can find the supported output_format at https://docs.cartesia.ai/api-reference/tts/bytes
  output_format={
    "container": "wav",
    "encoding": "pcm_f32le",
    "sample_rate": 44100,
  },
)
with open("sonic.wav", "wb") as f:
  f.write(response.read())
# Play the file
subprocess.run(["ffplay", "-autoexit", "-nodisp", "sonic.wav"])
次のコマンドでスクリプトを実行します。
env CARTESIA_API_KEY=YOUR_API_KEY python cartesia.py

# On uv
env CARTESIA_API_KEY=YOUR_API_KEY uv run cartesia.py
スクリプトはテキストをSonicに送信し、音声を取得して.wavファイルに保存します。
音声エージェントを設定する
Cartesia APIでは、速さ、感情、ローカライズなど、出力音声をさらに調整できます。
速さ
APIリクエストのvoiceオブジェクトで、__experimental_controls辞書にspeedパラメーターを加えます。
速さには次の値があります。
- “slowest”:非常にゆっくり
- “slow”:通常よりゆっくり
- “normal”:標準の速さ
- “fast”:通常より速い
- “fastest”:非常に速い
さらに細かく制御するには、[−1.0,1.0]の範囲の数値も使えます。0が標準で、負の値では遅く、正の値では速くなります。
"voice": {
  "mode": "id",
  "id": "VOICE_ID",
  "__experimental_controls": {
    "speed": "fast,
  }
}
感情
APIリクエストのvoiceオブジェクトで、__experimental_controls辞書にemotionパラメーターを加えます。これはemotion_name: levelの形式の「タグ」の配列です。
感情名にはanger、positivity、surprise、sadness、curiosityを指定できます。
強さはlowest、low、high、highestです。いずれも感情を加える指定です。たとえば「surprise: low」は驚きを少し加える指定であり、驚きを減らす意味ではありません。強さを省くと、中程度の感情を加えます。
"voice": {
  "mode": "id",
  "id": "VOICE_ID",
  "__experimental_controls": {
    "emotion": [
    "positivity:high",
    ]
  }
}
入力をストリーミングする
対話型のアプリでは、LLMなどのAIモデルから動的に音声を生成したいことがあります。Cartesia APIは、continuationsという機能でリアルタイムの音声生成に対応します。前の生成の声のパターンと文脈を保ち、終了した箇所から続きを生成します。
テキスト入力のcontext_idで設定します。連続する文の単語や句には、同じcontext_idを付けます。
{"transcript":
   "Hello, Sonic!",
   "continue": true,
   "context_id": "stream1"
}
{"transcript":
   " I'm streaming ",
   "continue": true,
   "context_id": "stream1"
}
{"transcript":
   "inputs.",
   "continue": false,
   "context_id": "stream1"
}
context_id付きの生成リクエストをTTS WebSocketエンドポイントに送ります。同じcontext_idの後続入力は、韻律を保ちながら生成を続けます。
音声AIエージェント、チャットボット、対話型の体験に便利な機能です。
音声AIエージェントのよくある質問
音声AIはもう実用的ですか
はい。企業は音声AIを積極的に導入しています。Cartesiaのような基盤は、高品質な音声生成、低レイテンシ、現実的な会話の声を提供します。情報データベースに基づく質問への回答に加え、予約、CRMへの記録、発信、見込み客の見極めなどを行えます。
どのような企業に役立ちますか
医療、コールセンター、ゲーム、医療保険などで、すでに使われています。毎月多くの電話を受ける企業なら、顧客対応を自動化し、業務の効率を改善できます。
英語以外も話せますか
はい。複数の言語に対応できますが、品質はTTSの提供元によります。たとえばCartesiaは、スペイン語、ドイツ語、フランス語、イタリア語、ヒンディー語など15言語に対応しています。
どの程度カスタマイズできますか
企業の具体的なニーズに合わせられます。自社データで学習して問い合わせに正確に答え、声も好みに合わせて調整できます。ウェブサイト、CRM、カレンダー、APIを備えるソフトウェアなど既存のシステムと連携し、現在の業務に組み込めます。
まだ機械的に聞こえますか
現在の音声AIでは、機械的な響きは大きく減っています。自然な間、割り込み、会話の細かな表現をよりよく扱えるようになりました。特にCartesiaのような高品質なTTSを使うと、AIと人間の音声の違いはますますわかりにくくなっています。