
Cómo crear un agente de voz con IA usando Cartesia
¿Te cansan las conversaciones robóticas con Siri y Alexa que terminan con “Lo siento, no te entiendo”? El futuro de la voz con IA ya está aquí. Los nuevos agentes pueden mantener conversaciones naturales, comprender el contexto y responder con una inteligencia similar a la humana.
A diferencia de los asistentes tradicionales que ejecutan órdenes básicas, estos agentes transforman la experiencia del cliente. En lugar de recorrer menús telefónicos como “Pulse 1 para inglés”, puedes decirle a la IA lo que necesitas, como si hablaras con una persona.
Veamos cómo crear estos agentes de voz con la API de Cartesia.
¿Qué son los agentes de voz con IA?
Son sistemas inteligentes que mantienen conversaciones naturales con personas. Comprenden el lenguaje hablado y responden, tanto a preguntas sencillas como a tareas complejas. Combinan reconocimiento del habla, procesamiento del lenguaje natural y tecnología de texto a voz para crear interacciones fluidas.
Pueden encargarse de tareas habituales como:
- Responder a preguntas frecuentes.
- Programar citas.
- Consultar el estado de un pedido.
- Dirigir llamadas al departamento adecuado.
- Ofrecer ayuda básica para resolver problemas.
Delegar estas interacciones rutinarias en la IA permite a los equipos dedicar tiempo y recursos a trabajos más complejos y valiosos.
¿Cómo funcionan los agentes de voz con IA?
Utilizan inteligencia artificial para procesar el habla, interpretar la intención, recuperar información de bases de conocimiento empresariales, generar respuestas de texto apropiadas y pronunciarlas con una voz natural y conversacional.
El proceso es el siguiente:
- Voz a texto, o ASR: el usuario habla y el sistema transcribe su voz mediante reconocimiento del habla.
- Procesamiento del lenguaje natural: analiza el texto para comprender el significado y la intención, incluidos contexto y matices.
- Recuperación de información: usa esa intención para obtener información relevante de su base de conocimiento.
- Generación de respuesta: crea una respuesta adecuada según el contexto y la información recuperada.
- Texto a voz: convierte la respuesta en habla natural para ofrecer una experiencia conversacional.
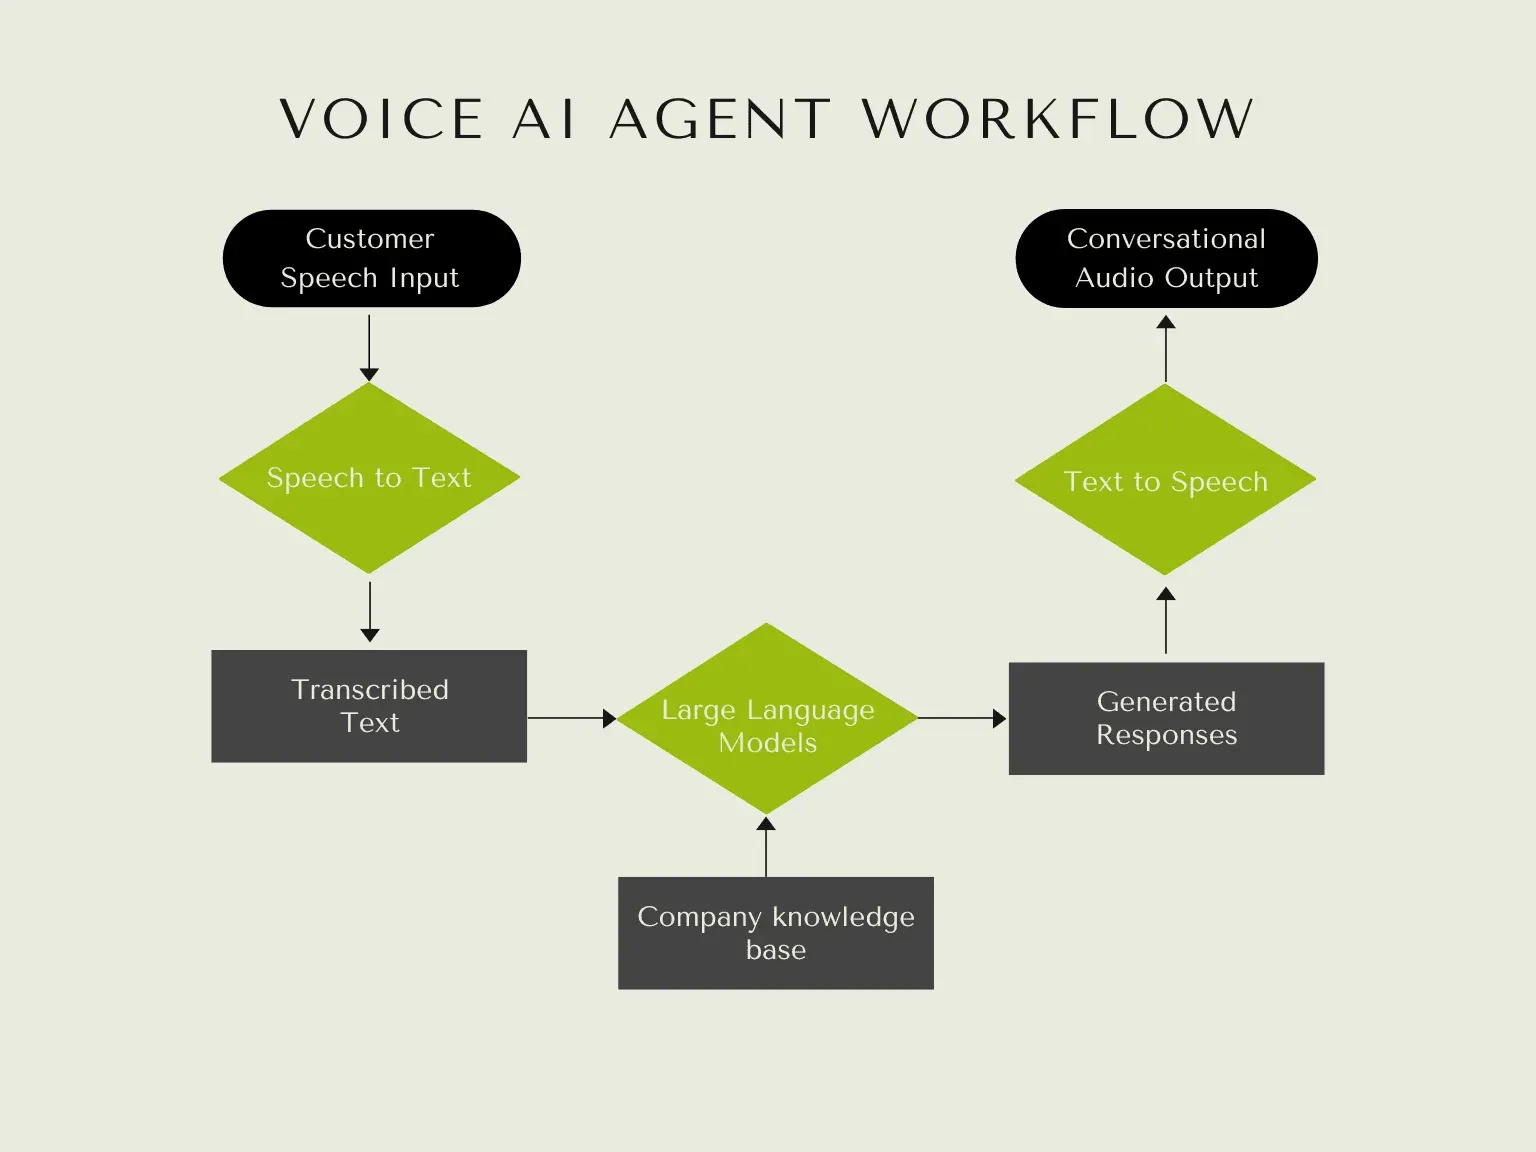
Proceso de un agente de voz con IA.
El agente puede iniciar la conversación siguiendo un guion pregrabado. Por ejemplo: “Me llamo _____. ¿En qué puedo ayudarte hoy?”
El sistema graba las respuestas, convierte el habla en texto y lo envía a tu LLM o sistema interno de IA en tiempo real. El LLM genera una respuesta que el agente convierte en voz. La conversación puede continuar hasta alcanzar el objetivo, como confirmar una cita o resolver un problema habitual.
Crear un agente de voz con la API de Cartesia en Python
Este tutorial explica cómo configurar un agente con la API de Cartesia y el modelo Sonic.
Configura el entorno
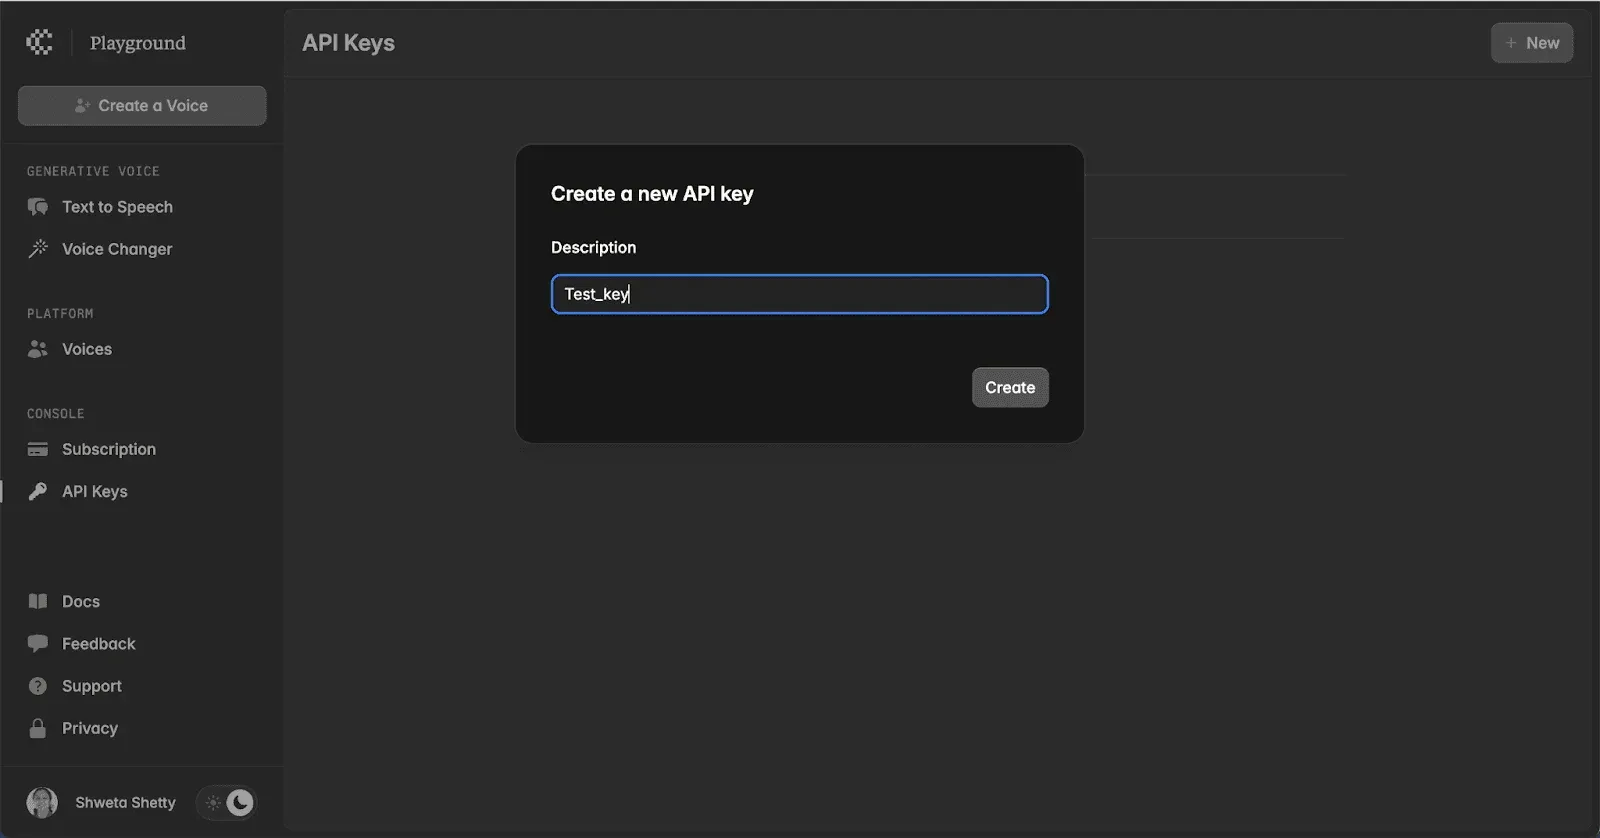
Para usar la API de Cartesia necesitas una cuenta, una clave de API y FFmpeg instalado. Sigue estos pasos:
- Crea una cuenta en Cartesia Play.
- Obtén tu clave en Cartesia API Keys.
- Instala FFmpeg para procesar audio:
# On Ubuntu/Debian
  sudo apt update && sudo apt install ffmpeg

# On macOS (using Homebrew)
  brew install ffmpeg

# On Windows (using Chocolatey)
  choco install ffmpeg
FFmpeg no es obligatorio para usar la API de Cartesia, pero ayuda a convertir, guardar y reproducir archivos de audio.
Elige el endpoint de voz a texto
Primero debes grabar la entrada del cliente y convertirla en texto. Hay varias opciones. Por ejemplo, la API de Whisper de OpenAI admite distintos formatos de audio y transcribe varios idiomas. También puede traducir habla de otros idiomas al inglés. Otra posibilidad es usar servicios como Google Speech to Text, Amazon Transcribe, Azure AI Speech, Assembly, Deepgram o Speechmatics.
Genera una respuesta a partir del texto transcrito
La generación de respuestas depende de la función principal de tu aplicación. Un agente sanitario tendrá que comunicarse con tus aplicaciones médicas de IA y bases de datos sanitarias. Uno que programa citas deberá consultar tus calendarios. Esto suele requerir otro modelo de IA con mayor capacidad de razonamiento, como Anthropic Claude Sonnet o los modelos OpenAI O1 o 4O.
También puedes usar una plataforma de agentes de voz
Si esta configuración te parece demasiado compleja, puedes empezar con plataformas como LiveKit, VAPI o RASA.
Una prueba de concepto sencilla ocupa solo cincuenta líneas de código, sin contar espacios en blanco ni comentarios:
load_dotenv(dotenv_path=".env.local")
logger = logging.getLogger("voice-agent")

def prewarm(proc: JobProcess):
  proc.userdata["vad"] = silero.VAD.load()
async def entrypoint(ctx: JobContext):
  initial_chat_context = llm.ChatContext().append(
      role="system",
      text=(
        "You are a voice assistant created by LiveKit. Your interface with users will be voice. "
        "You should use short and concise responses, and avoid usage of unpronounceable punctuation. "
      ),
  )
  logger.info(f"connecting to room {ctx.room.name}")
  await ctx.connect(auto_subscribe=AutoSubscribe.AUDIO_ONLY)
  # Wait for the first participant to connect
  participant = await ctx.wait_for_participant()
  logger.info(f"starting voice assistant for participant {participant.identity}")

  # Set up the Agent
    agent = VoicePipelineAgent(
      vad=ctx.proc.userdata["vad"],
      stt=deepgram.STT(),
      llm=openai.LLM(model="gpt-4o-mini"),
      tts=cartesia.TTS(
        model="sonic-3.5",
        voice="a0e99841-438c-4a64-b679-ae501e7d6091",
      ),
      chat_ctx=initial_chat_context,
    )
     agent.start(ctx.room, participant)

  # Once connected, we start by hardcoding a greeting
    await agent.say(f"Hey {participant.identity}! How can I help you today?", allow_interruptions=True)

  if __name__ == "__main__":
    cli.run_app(
      WorkerOptions(
        entrypoint_fnc=entrypoint,
        prewarm_fnc=prewarm,
      ),
    )
Da formato al texto de entrada
Un texto bien formateado ayuda a generar habla natural. Estas prácticas son útiles:
- Usa puntuación para señalar preguntas y énfasis.
- Desarrolla las abreviaturas para evitar pronunciaciones incorrectas, por ejemplo “Doctor” en lugar de “Dr.”.
- Estructura el texto siguiendo el ritmo del habla natural.
También puedes usar etiquetas
Ejemplo de guion
¡Hola! Gracias por llamar a nuestro servicio de atención al cliente.
<break time="1s" />
  I’m Anna, how can I help you today?
<break time="1s" />
  Could you please provide your order number so we can get started? We’ll resolve this as quickly as possible and keep you updated.
<break time="1s" />
Elige el endpoint de texto a voz
Cartesia ofrece varios endpoints TTS. Los endpoints WebSocket y de streaming son adecuados para agentes interactivos por estos motivos:
- Latencia: puedes establecer la conexión WebSocket de antemano para evitar el tiempo de conexión al empezar a generar voz. Esto suele ahorrar unos 200 ms.
- Entrada en streaming: puedes enviar entradas de forma continua manteniendo la prosodia, algo útil cuando el texto se genera en tiempo real, por ejemplo con un LLM.
- Marcas temporales: puedes obtener transcripciones con marcas de tiempo para crear subtítulos o transcripciones en directo. Hay límites según el modelo y el idioma. Consulta Comparación de endpoints TTS.
- Multiplexación: puedes mantener varias conversaciones mediante una sola conexión.
El endpoint TTS bytes mediante POST es adecuado para generar archivos de audio de antemano en formatos como WAV y MP3.
Antes de elegir, consulta la documentación de endpoints TTS de Cartesia para decidir cuál se ajusta a tu aplicación.
Llama a la API
Cuando el texto tenga el formato adecuado, envíalo al endpoint elegido. La API espera una carga JSON con el texto y parámetros de configuración opcionales. Puedes configurarlo con el SDK de Cartesia para Python:
pip install cartesia

# Or using uv
uv add cartesia

# Make the API call
import os
import subprocess
from cartesia import Cartesia
if os.environ.get("CARTESIA_API_KEY") is None:
  raise ValueError("CARTESIA_API_KEY is not set")

client = Cartesia(api_key=os.environ.get("CARTESIA_API_KEY"))

response = client.tts.generate(
  model_id="sonic-3.5",
  transcript="Hello, world! I'm generating audio on Cartesia.",
  voice={"mode": "id", "id": "a0e99841-438c-4a64-b679-ae501e7d6091"},  # Greg - Supporter
  language="en",

  # You can find the supported output_format at https://docs.cartesia.ai/api-reference/tts/bytes
  output_format={
    "container": "wav",
    "encoding": "pcm_f32le",
    "sample_rate": 44100,
  },
)
with open("sonic.wav", "wb") as f:
  f.write(response.read())
# Play the file
subprocess.run(["ffplay", "-autoexit", "-nodisp", "sonic.wav"])
Ejecuta el script así:
env CARTESIA_API_KEY=YOUR_API_KEY python cartesia.py

# On uv
env CARTESIA_API_KEY=YOUR_API_KEY uv run cartesia.py
El script envía el texto a Sonic, recibe el audio generado y lo guarda como archivo .wav.
Configura tu agente de voz
La API de Cartesia permite personalizar la voz, incluida la velocidad, la emoción y la localización.
Velocidad
Añade el parámetro speed al diccionario __experimental_controls del objeto voice en la solicitud para personalizar la velocidad.
Las opciones son:
- “slowest”: habla muy lenta.
- “slow”: más lenta de lo normal.
- “normal”: velocidad predeterminada.
- “fast”: más rápida de lo normal.
- “fastest”: habla muy rápida.
También puedes definir un número dentro del intervalo [−1.0,1.0] para un control más preciso. El 0 representa la velocidad predeterminada; los valores negativos la reducen y los positivos la aumentan.
"voice": {
  "mode": "id",
  "id": "VOICE_ID",
  "__experimental_controls": {
    "speed": "fast,
  }
}
Emoción
Añade emotion al diccionario __experimental_controls del objeto voice de la solicitud. El parámetro es una lista de etiquetas con el formato emotion_name: level.
Los nombres de emoción pueden ser anger, positivity, surprise, sadness y curiosity.
Los niveles son lowest, low, high y highest. Siempre añaden emoción. Por ejemplo, “surprise: low” añade un poco de sorpresa; no hace que la voz suene menos sorprendida. Omite el nivel para añadir una cantidad moderada.
"voice": {
  "mode": "id",
  "id": "VOICE_ID",
  "__experimental_controls": {
    "emotion": [
    "positivity:high",
    ]
  }
}
Envía entradas en streaming
En aplicaciones interactivas puedes necesitar generar habla dinámicamente a partir de un modelo de IA, como un LLM. La API de Cartesia admite generación de voz en tiempo real mediante continuations. Estas continúan la generación donde terminó la anterior, conservando su patrón sonoro y contexto.
Se configuran mediante context_id en la entrada de texto. Todas las palabras o frases de una oración continua deben compartir el mismo context_id.
{"transcript":
   "Hello, Sonic!",
   "continue": true,
   "context_id": "stream1"
}
{"transcript":
   " I'm streaming ",
   "continue": true,
   "context_id": "stream1"
}
{"transcript":
   "inputs.",
   "continue": false,
   "context_id": "stream1"
}
Puedes enviar la solicitud con context_id al endpoint TTS WebSocket. Las entradas posteriores con el mismo context_id continúan la generación y conservan la prosodia.
Esta función resulta útil para agentes de voz, chatbots y experiencias interactivas.
Preguntas frecuentes sobre agentes de voz con IA
¿Ya se puede utilizar esta tecnología?
Sí, las empresas están adoptando soluciones de voz con IA. Plataformas como Cartesia permiten generar voz de alta calidad, con baja latencia y voces conversacionales realistas. Los agentes pueden responder según una base de información y realizar tareas como programar citas, crear registros en un CRM, hacer llamadas salientes y cualificar contactos comerciales.
¿Qué empresas pueden beneficiarse?
Sectores como sanidad, centros de llamadas, videojuegos y seguros médicos ya utilizan agentes de voz con IA. Cualquier empresa con muchas llamadas mensuales puede beneficiarse al automatizar interacciones y mejorar la eficiencia operativa.
¿Pueden hablar idiomas distintos del inglés?
Sí, pueden admitir varios idiomas, aunque la calidad depende del proveedor de texto a voz. Por ejemplo, Cartesia admite 15 idiomas, incluidos español, alemán, francés, italiano e hindi.
¿Hasta qué punto se pueden personalizar?
Pueden adaptarse a las necesidades de tu empresa. Es posible entrenarlos con tus datos para responder con exactitud a consultas y personalizar sus voces según tus preferencias. También pueden integrarse con sistemas existentes, como sitios web, CRM, calendarios y cualquier software con endpoints API, para incorporarse a tus procesos.
¿Siguen sonando robóticos?
No, la tecnología moderna ha reducido mucho ese efecto. La generación de habla gestiona mejor las pausas naturales, las interrupciones y los matices conversacionales. Cada vez cuesta más distinguir el habla generada por IA de la humana, especialmente con proveedores TTS de alta calidad como Cartesia.