
Comment créer un agent vocal IA avec Cartesia
Vous en avez assez des conversations robotiques avec Siri et Alexa qui se terminent par « Désolé, je ne comprends pas » ? L’avenir de l’IA vocale est là. Ces nouveaux agents IA peuvent tenir des conversations naturelles, comprendre le contexte et répondre avec une intelligence proche de celle d’un humain.
Les assistants vocaux traditionnels exécutent surtout des commandes simples. Ces agents IA changent l’expérience client. Au lieu de parcourir de longs menus téléphoniques « Appuyez sur 1 pour l’anglais », vous pouvez simplement dire à l’IA ce dont vous avez besoin, comme à une personne.
Voyons comment créer ces agents vocaux IA avec l’API Cartesia.
Qu’est-ce qu’un agent vocal IA ?
Les agents vocaux IA sont des systèmes intelligents qui tiennent des conversations naturelles avec des humains. Ils comprennent le langage parlé et y répondent, qu’il s’agisse de questions simples ou de tâches complexes. Ils associent reconnaissance vocale, traitement du langage naturel et synthèse vocale pour rendre les échanges fluides.
Les agents vocaux IA peuvent prendre en charge de nombreuses tâches courantes, par exemple :
- Répondre aux questions fréquentes
- Planifier des rendez-vous
- Vérifier le statut d’une commande
- Transférer les appels au bon service
- Fournir une assistance de dépannage de premier niveau
En confiant ces échanges courants à l’IA, les équipes peuvent se concentrer sur des tâches plus complexes et plus utiles, et mieux employer leur temps et leurs ressources.
Comment fonctionnent les agents vocaux IA ?
Les agents vocaux IA utilisent l’intelligence artificielle pour traiter la parole humaine, en interpréter l’intention, rechercher des informations dans les bases de connaissances de l’entreprise, formuler une réponse textuelle adaptée et la restituer d’une voix naturelle et conversationnelle.
Voici les étapes du processus.
- Reconnaissance vocale (ASR) : l’utilisateur parle et le système IA transcrit sa voix en texte.
- Traitement du langage naturel : le système analyse le texte pour comprendre le sens et l’intention de l’utilisateur, y compris le contexte et les nuances.
- Recherche d’informations : à partir de cette intention, l’agent IA récupère les informations pertinentes dans sa base de connaissances pour préparer une réponse.
- Génération de la réponse : l’IA produit une réponse adaptée au contexte de la conversation et aux informations récupérées.
- Synthèse vocale : l’agent IA convertit le texte de la réponse en parole naturelle pour l’utilisateur, afin de créer une expérience conversationnelle.
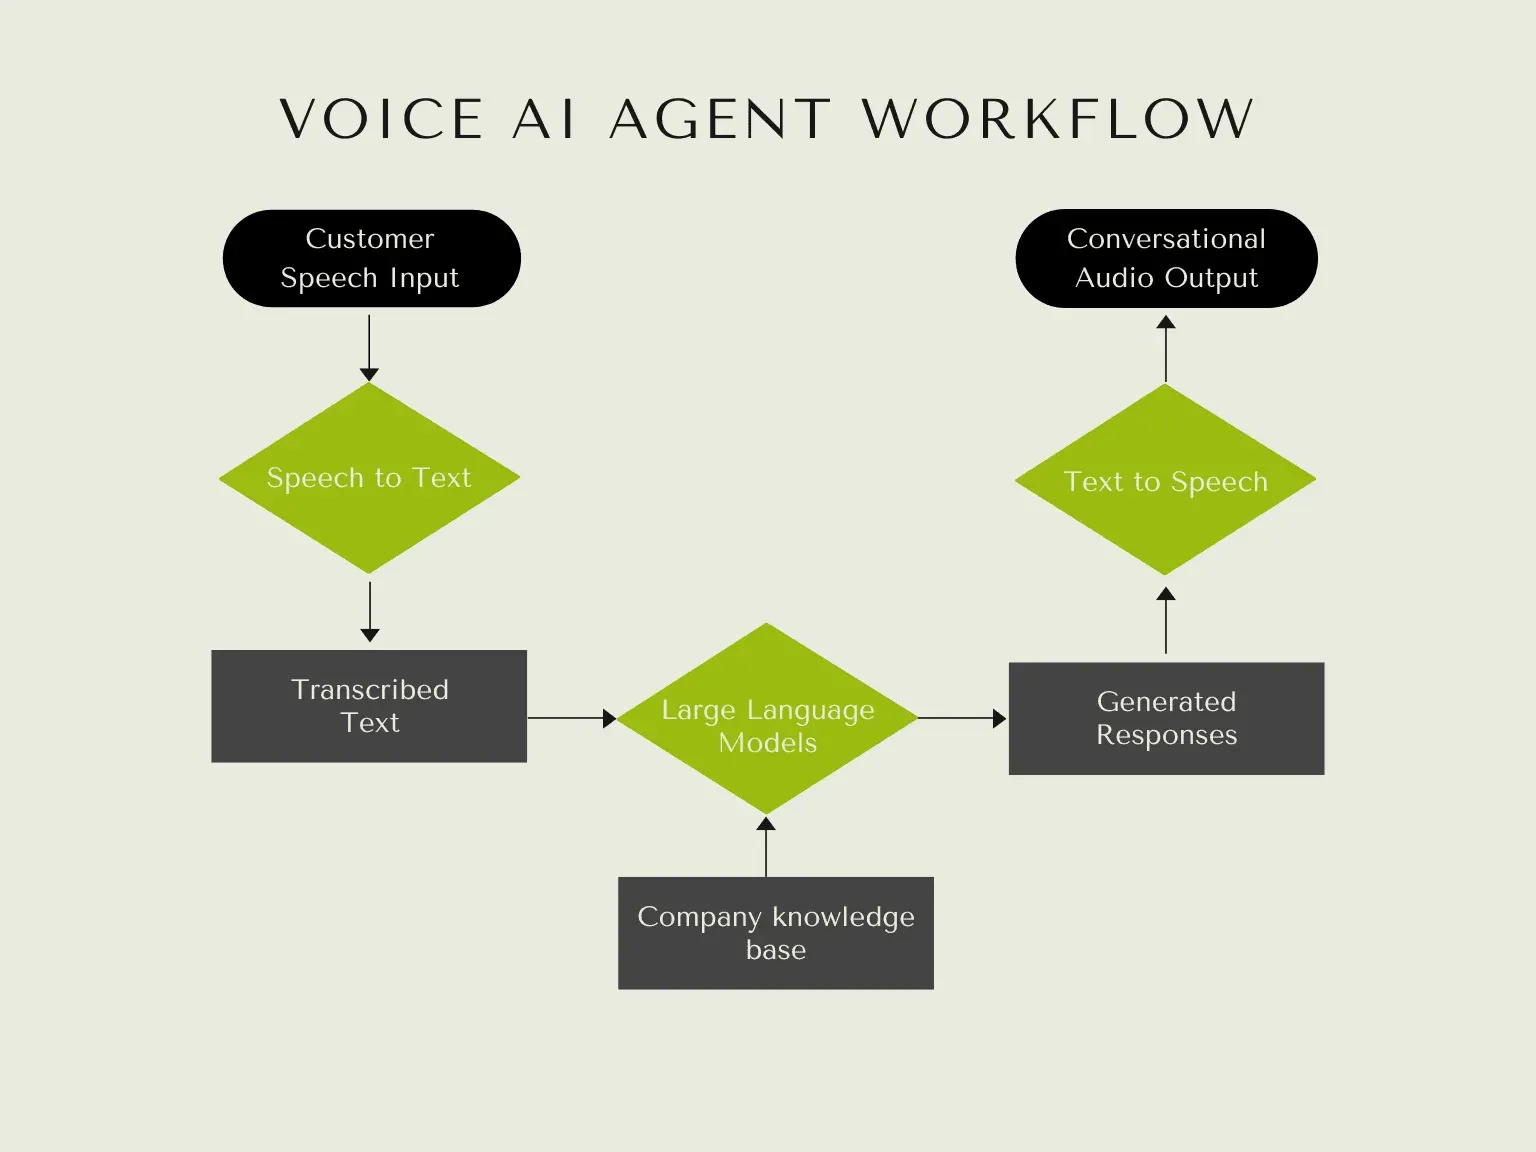
Processus d’un agent vocal IA
L’agent IA peut commencer la conversation en suivant un script préenregistré. Par exemple : « Je m’appelle _____. Comment puis-je vous aider aujourd’hui ? »
Votre système peut ensuite enregistrer les réponses de l’utilisateur, convertir la parole en texte et transmettre ce texte à votre LLM ou à votre système IA interne en temps réel. Le LLM génère une réponse textuelle adaptée, que l’agent vocal IA peut convertir en parole. La conversation se poursuit entre l’agent et l’utilisateur jusqu’à ce que votre système atteigne son objectif, par exemple confirmer un rendez-vous ou résoudre un problème courant.
Créer un agent vocal IA avec l’API Cartesia en Python
Ce tutoriel vous guide dans la configuration d’un agent vocal IA avec l’API Cartesia et le modèle Sonic.
Configurer l’environnement
Pour utiliser l’API Cartesia, préparez un compte, une clé API et une installation de FFmpeg. Procédez comme suit :
- Créez un compte Cartesia sur Cartesia Play.
- Récupérez votre clé API dans Cartesia API Keys.
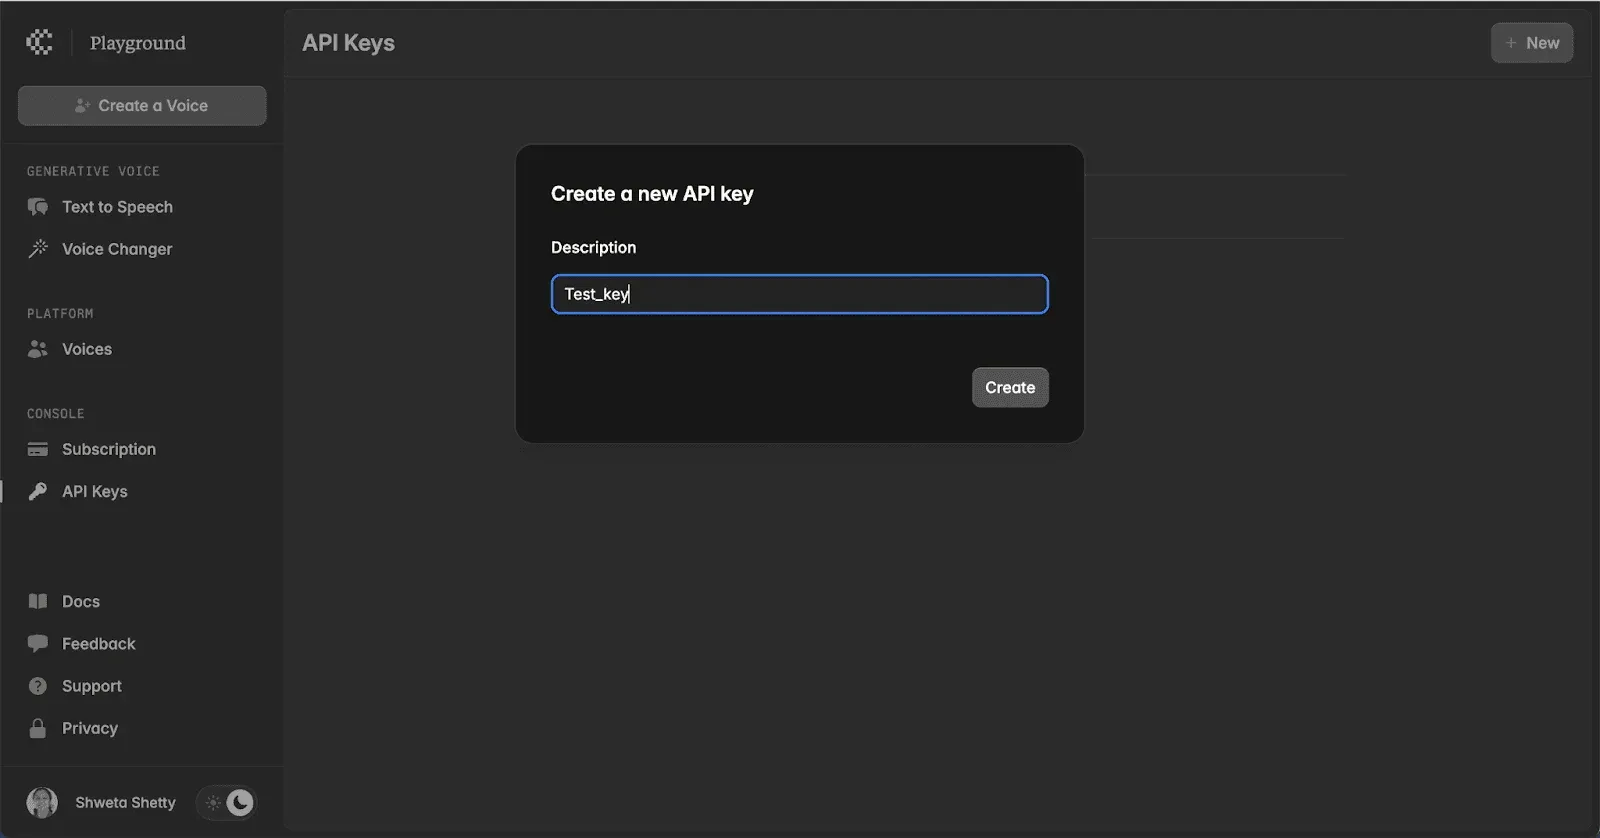
- Installez FFmpeg pour traiter l’audio, comme indiqué ci-dessous.
# On Ubuntu/Debian
  sudo apt update && sudo apt install ffmpeg

# On macOS (using Homebrew)
  brew install ffmpeg

# On Windows (using Chocolatey)
  choco install ffmpeg
FFmpeg n’est pas nécessaire pour utiliser l’API Cartesia, mais il est utile pour convertir, enregistrer et lire des fichiers audio.
Choisir votre point de terminaison de transcription audio
Commencez par enregistrer la parole du client et la convertir en texte. Plusieurs technologies de transcription audio sont disponibles. Vous pouvez par exemple utiliser l’API Whisper d’OpenAI, qui prend en charge plusieurs formats audio et transcrit la parole dans plusieurs langues. Elle peut aussi traduire en anglais des enregistrements dans d’autres langues. Vous pouvez également utiliser Google Speech to Text, Amazon Transcribe, Azure AI Speech, Assembly, Deepgram ou Speechmatics.
Générer une réponse à partir du texte transcrit
La génération d’une réponse dépend de la fonction principale de votre application IA. Si votre agent intervient dans la santé, il doit communiquer avec vos applications IA médicales et vos bases de données de santé existantes. Pour planifier des rendez-vous, il doit consulter vos applications de calendrier. Cette fonctionnalité nécessite généralement un autre modèle IA doté de capacités de raisonnement plus avancées, comme Anthropic Claude Sonnet ou OpenAI O1 ou 4O.
Utiliser une plateforme d’agents vocaux IA
Si cette configuration vous paraît trop complexe, vous pouvez aussi essayer des plateformes comme LiveKit, VAPI ou RASA pour commencer à créer des agents vocaux IA.
Le prototype d’agent vocal le plus simple tient en cinquante lignes de code, hors espaces et commentaires :
load_dotenv(dotenv_path=".env.local")
logger = logging.getLogger("voice-agent")

def prewarm(proc: JobProcess):
  proc.userdata["vad"] = silero.VAD.load()
async def entrypoint(ctx: JobContext):
  initial_chat_context = llm.ChatContext().append(
      role="system",
      text=(
        "You are a voice assistant created by LiveKit. Your interface with users will be voice. "
        "You should use short and concise responses, and avoid usage of unpronounceable punctuation. "
      ),
  )
  logger.info(f"connecting to room {ctx.room.name}")
  await ctx.connect(auto_subscribe=AutoSubscribe.AUDIO_ONLY)
  # Wait for the first participant to connect
  participant = await ctx.wait_for_participant()
  logger.info(f"starting voice assistant for participant {participant.identity}")

  # Set up the Agent
    agent = VoicePipelineAgent(
      vad=ctx.proc.userdata["vad"],
      stt=deepgram.STT(),
      llm=openai.LLM(model="gpt-4o-mini"),
      tts=cartesia.TTS(
        model="sonic-3.5",
        voice="a0e99841-438c-4a64-b679-ae501e7d6091",
      ),
      chat_ctx=initial_chat_context,
    )
     agent.start(ctx.room, participant)

  # Once connected, we start by hardcoding a greeting
    await agent.say(f"Hey {participant.identity}! How can I help you today?", allow_interruptions=True)

  if __name__ == "__main__":
    cli.run_app(
      WorkerOptions(
        entrypoint_fnc=entrypoint,
        prewarm_fnc=prewarm,
      ),
    )
Mettre en forme le texte d’entrée
Une bonne mise en forme du texte est essentielle pour obtenir une voix naturelle. Voici quelques bonnes pratiques :
- Utilisez la ponctuation pour marquer les questions et l’insistance afin de produire une parole naturelle.
- Développez les abréviations pour éviter les erreurs de prononciation, par exemple « Docteur » au lieu de « Dr ».
- Structurez le texte selon le rythme naturel de la parole.
Vous pouvez aussi utiliser des balises
Exemple de script
Bonjour ! Merci d’avoir appelé notre service client.
<break time="1s" />
  I’m Anna, how can I help you today?
<break time="1s" />
  Could you please provide your order number so we can get started? We’ll resolve this as quickly as possible and keep you updated.
<break time="1s" />
Choisir votre point de terminaison de synthèse vocale
Cartesia propose plusieurs points de terminaison TTS. Les points de terminaison WebSocket et de diffusion en continu conviennent aux agents vocaux interactifs pour les raisons suivantes :
- Latence : vous pouvez établir une connexion WebSocket à l’avance, ce qui évite la latence de connexion au début de la génération vocale. Cela économise généralement environ 200 ms.
- Entrée en continu : vous pouvez envoyer les entrées au fil de leur production tout en conservant la prosodie de la voix générée. C’est utile lorsque le texte est produit en temps réel, notamment par un LLM.
- Horodatages : vous pouvez obtenir des transcriptions horodatées de la parole générée pour créer des sous-titres ou des transcriptions en direct. Des limites s’appliquent selon le modèle et la langue. Consultez la comparaison des points de terminaison TTS.
- Multiplexage : plusieurs conversations peuvent partager une même connexion.
Le point de terminaison TTS bytes (POST) est adapté à la génération préalable d’un fichier audio. Il permet de produire différents formats, notamment WAV et MP3.
Avant de choisir, consultez la documentation des points de terminaison TTS Cartesia pour déterminer celui qui convient à votre application.
Appeler l’API
Une fois le texte correctement mis en forme, envoyez-le au point de terminaison TTS choisi. L’API attend une charge utile JSON contenant le texte et des paramètres de configuration facultatifs. Voici comment procéder avec le SDK Cartesia.
pip install cartesia

# Or using uv
uv add cartesia

# Make the API call
import os
import subprocess
from cartesia import Cartesia
if os.environ.get("CARTESIA_API_KEY") is None:
  raise ValueError("CARTESIA_API_KEY is not set")

client = Cartesia(api_key=os.environ.get("CARTESIA_API_KEY"))

response = client.tts.generate(
  model_id="sonic-3.5",
  transcript="Hello, world! I'm generating audio on Cartesia.",
  voice={"mode": "id", "id": "a0e99841-438c-4a64-b679-ae501e7d6091"},  # Greg - Supporter
  language="en",

  # You can find the supported output_format at https://docs.cartesia.ai/api-reference/tts/bytes
  output_format={
    "container": "wav",
    "encoding": "pcm_f32le",
    "sample_rate": 44100,
  },
)
with open("sonic.wav", "wb") as f:
  f.write(response.read())
# Play the file
subprocess.run(["ffplay", "-autoexit", "-nodisp", "sonic.wav"])
Exécutez le script comme indiqué ci-dessous.
env CARTESIA_API_KEY=YOUR_API_KEY python cartesia.py

# On uv
env CARTESIA_API_KEY=YOUR_API_KEY uv run cartesia.py
Ce script envoie le texte au modèle Sonic, récupère l’audio généré et l’enregistre dans un fichier .wav.
Configurer votre agent vocal
L’API Cartesia permet de personnaliser davantage la voix, notamment sa vitesse, son émotion et sa localisation.
Vitesse
Pour personnaliser la vitesse, ajoutez le paramètre speed au dictionnaire __experimental_controls de l’objet voice dans votre requête API.
Les options de vitesse sont les suivantes :
- “slowest” : parole très lente
- “slow” : parole plus lente que la normale
- “normal” : débit par défaut
- “fast” : parole plus rapide que la normale
- “fastest” : parole très rapide
Vous pouvez aussi définir la vitesse par un nombre dans l’intervalle [−1.0,1.0] pour un réglage plus précis. La valeur 0 correspond à la vitesse par défaut. Les valeurs négatives ralentissent la parole et les valeurs positives l’accélèrent.
"voice": {
  "mode": "id",
  "id": "VOICE_ID",
  "__experimental_controls": {
    "speed": "fast,
  }
}
Émotion
Pour personnaliser l’émotion, ajoutez le paramètre emotion au dictionnaire __experimental_controls de l’objet voice dans votre requête API. Ce paramètre est un tableau de balises au format emotion_name: level.
Les noms d’émotion disponibles sont anger, positivity, surprise, sadness et curiosity.
Les niveaux sont lowest, low, high et highest. Leur effet est uniquement additif. Par exemple, « surprise: low » ajoute un peu de surprise à la voix, sans réduire celle qu’elle exprime déjà. Omettez le niveau pour ajouter une quantité modérée de l’émotion.
"voice": {
  "mode": "id",
  "id": "VOICE_ID",
  "__experimental_controls": {
    "emotion": [
    "positivity:high",
    ]
  }
}
Envoyer les entrées en continu
Pour les applications interactives, vous pouvez générer la parole dynamiquement à partir d’un modèle IA, par exemple un grand modèle de langage (LLM). L’API Cartesia permet la génération vocale en temps réel grâce aux continuations. Elles reprennent la génération là où elle s’est arrêtée tout en conservant les caractéristiques sonores et le contexte de la génération précédente.
La continuation se configure avec context_id dans votre entrée textuelle. Tous les mots ou segments d’une même phrase continue doivent porter le même context_id.
{"transcript":
   "Hello, Sonic!",
   "continue": true,
   "context_id": "stream1"
}
{"transcript":
   " I'm streaming ",
   "continue": true,
   "context_id": "stream1"
}
{"transcript":
   "inputs.",
   "continue": false,
   "context_id": "stream1"
}
Envoyez la requête de génération avec context_id au point de terminaison TTS WebSocket. Les entrées suivantes portant le même context_id prolongeront la génération en conservant la prosodie.
Cette fonctionnalité est utile pour les agents vocaux IA, les chatbots et les expériences interactives.
Questions fréquentes sur les agents vocaux IA
La technologie d’IA vocale est-elle déjà utilisable ?
Oui, les entreprises adoptent déjà des solutions d’IA vocale. Des plateformes comme Cartesia permettent une génération vocale de qualité, une faible latence et des voix conversationnelles réalistes. Les agents vocaux IA peuvent répondre à des questions à partir d’une base d’informations, planifier des rendez-vous, créer des fiches CRM, passer des appels sortants et qualifier des prospects.
Quelles entreprises peuvent bénéficier des agents vocaux IA ?
La santé, les centres d’appels, les jeux vidéo, l’assurance maladie et d’autres secteurs utilisent déjà des agents vocaux IA. Toute entreprise qui reçoit un grand nombre d’appels chaque mois peut en tirer parti pour automatiser les échanges clients et améliorer son efficacité opérationnelle.
Les agents vocaux IA peuvent-ils parler d’autres langues que l’anglais ?
Oui, ils peuvent prendre en charge plusieurs langues, mais la qualité dépend du fournisseur de synthèse vocale. Cartesia prend par exemple en charge 15 langues, dont l’espagnol, l’allemand, le français, l’italien et l’hindi.
Jusqu’où peut-on personnaliser les agents vocaux IA ?
Les agents vocaux IA peuvent être adaptés aux besoins précis de votre entreprise. Ils peuvent être entraînés sur vos données pour répondre correctement aux questions des clients, et leurs voix peuvent être personnalisées selon vos préférences. Ils peuvent aussi s’intégrer à vos systèmes existants, notamment vos sites web, plateformes CRM, calendriers et logiciels disposant de points de terminaison API, pour s’insérer dans vos processus actuels.
Les agents vocaux IA ont-ils encore une voix robotique ?
Non, les technologies modernes d’IA vocale ont nettement réduit cet effet. La génération vocale gère mieux les pauses naturelles, les interruptions et les nuances de la conversation. La différence entre la parole générée par l’IA et celle d’un humain devient de plus en plus difficile à percevoir, surtout avec des fournisseurs de synthèse vocale de qualité comme Cartesia.